Cekura Bench
语音对语音模型在实际通话中的基准测试
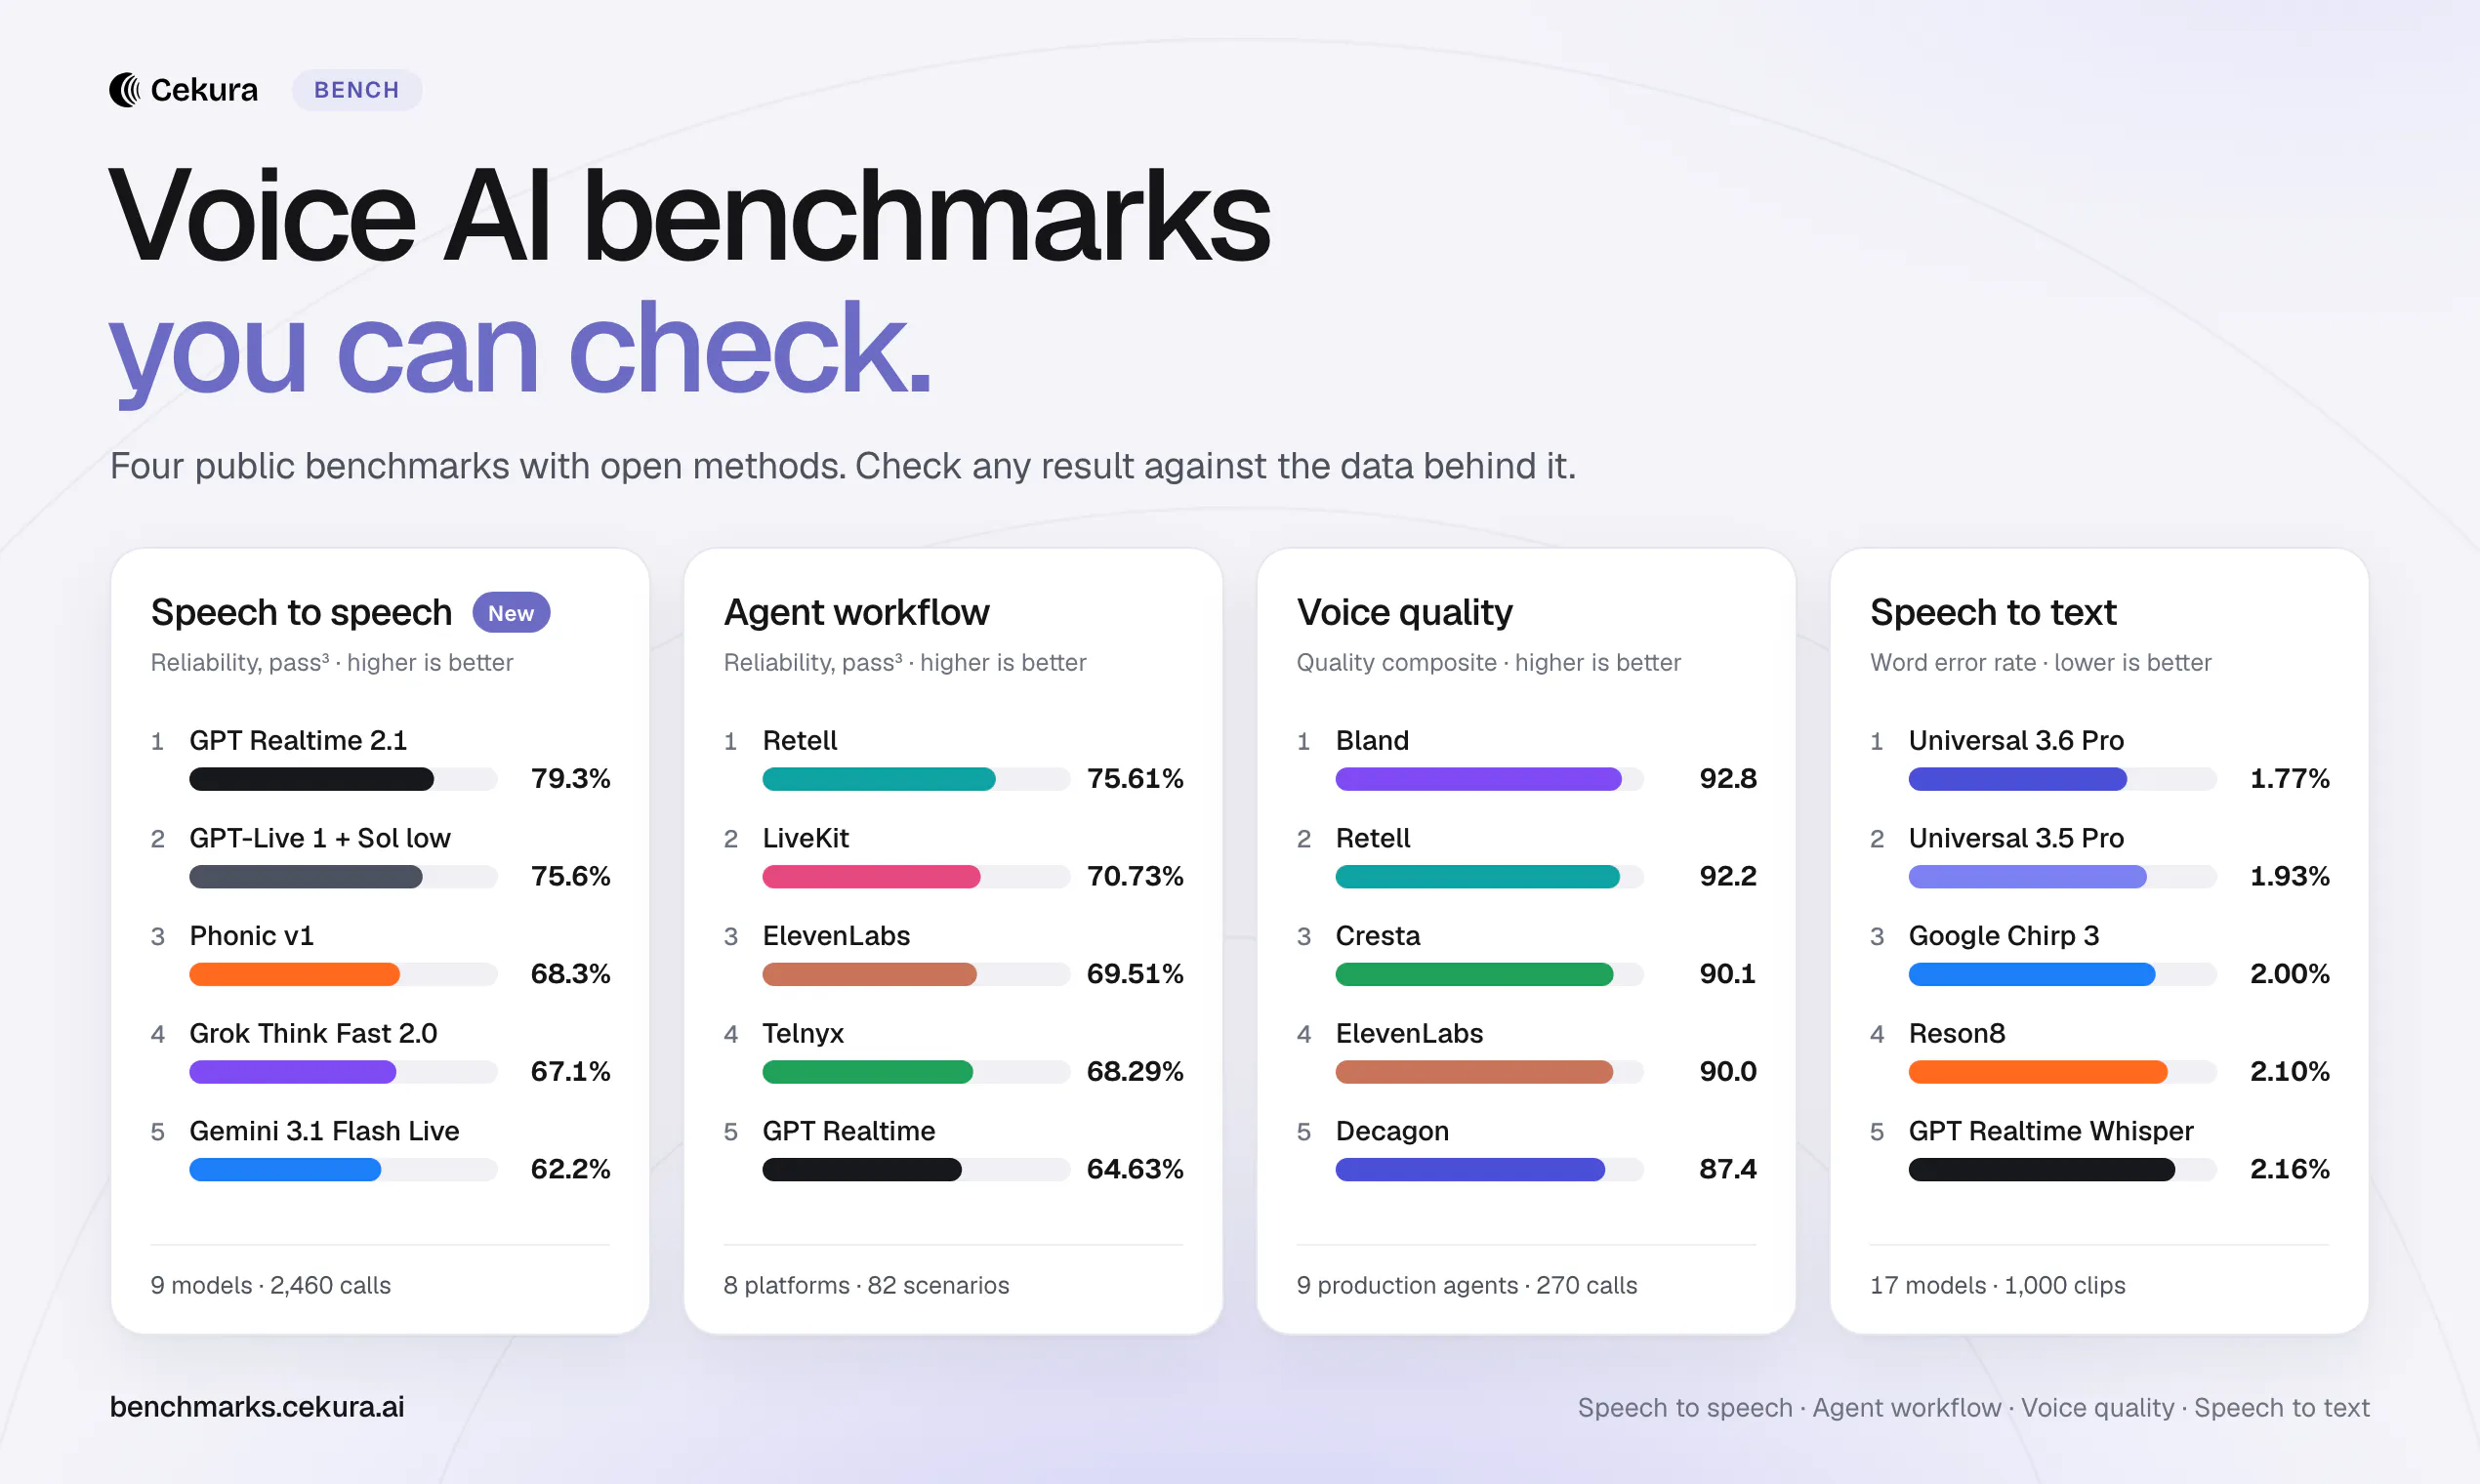
Cekura Bench 发布可供验证的语音 AI 基准测试结果。我们全新的语音转语音基准测试涵盖 9 个实时语音模型,包括 GPT Realtime 2.1、Gemini Live、Grok 和 Phonic,测试内容为完整的电话客服系统在实时通话中的表现:共 82 个场景,每个场景运行三次。模型排名依据可靠性、数据准确性、通话中断率、响应时间和成本,所有通话记录均公开。Cekura Bench 还涵盖语音客服基准测试和语音转语音 (STT) 基准测试,文本转语音 (TTS) 基准测试即将推出。
AI 分析
Cekura Bench是一个透明的语音到语音AI模型基准测试平台,以实时电话代理形式测试模型。核心功能包括在82个场景中对9个实时模型(GPT Realtime 2.1、Gemini Live、Grok、Phonic等)进行三次测试,根据可靠性、数据准确性、呼叫停滞、响应时间和成本进行排名。所有记录均公开。同时提供语音代理和STT基准(TTS即将推出)。独特卖点是可验证的真实世界实时通话测试,解决语音AI领域基准不透明或合成数据的痛点。价值主张:帮助开发者和企业基于数据选择模型并确保完全透明。
有利,因为2025-2026年实时语音AI代理和客户服务将呈爆发式增长,OpenAI、Google和xAI等公司的技术日益成熟。用户对可靠性能数据的需求上升,同时对模型幻觉和通话失败的担忧增加。追求AI效率的经济趋势使独立基准测试变得至关重要。优秀时机。
高。技术难度可控,可利用现有电话API和云基础设施运行并行测试并发布记录。开发成本适中;API使用和通话的持续运营成本是主要挑战,但作为SaaS具有可扩展性。供应链风险低,合规可通过匿名化数据管理。可扩展性潜力强。评分:高。
主要细分:AI开发者、语音AI工程师、构建对话代理的SaaS/科技公司产品团队(人口统计:25-45岁科技专业人士)。行业:人工智能、开发者工具、客户体验。地理分布:全球,以美国、欧洲、中国为主。语音AI市场TAM到2026年预计达数十亿美元;基准测试SAM达数亿美元。核心痛点:没有真实世界测试时模型选择不可靠。对可信、更新基准的订阅付费意愿高。
中等。直接竞争对手:1. Artificial Analysis (artificialanalysis.ai),2. LMSYS Chatbot Arena (arena.lmsys.org),3. Hugging Face Leaderboards (huggingface.co),4. LiveBench (livebench.ai)。优势:独特专注于实时电话语音到语音作为完整代理,公开记录,实际指标如呼叫停滞。劣势:作为新进入者,范围较窄(目前仅9个模型),对比更广泛的LLM基准;维护成本可能较高。在语音细分领域差异化明显。
升级 Pro 解锁完整 AI 分析