iFixAi
对人工智能代理进行独立审计,以发现不协调之处
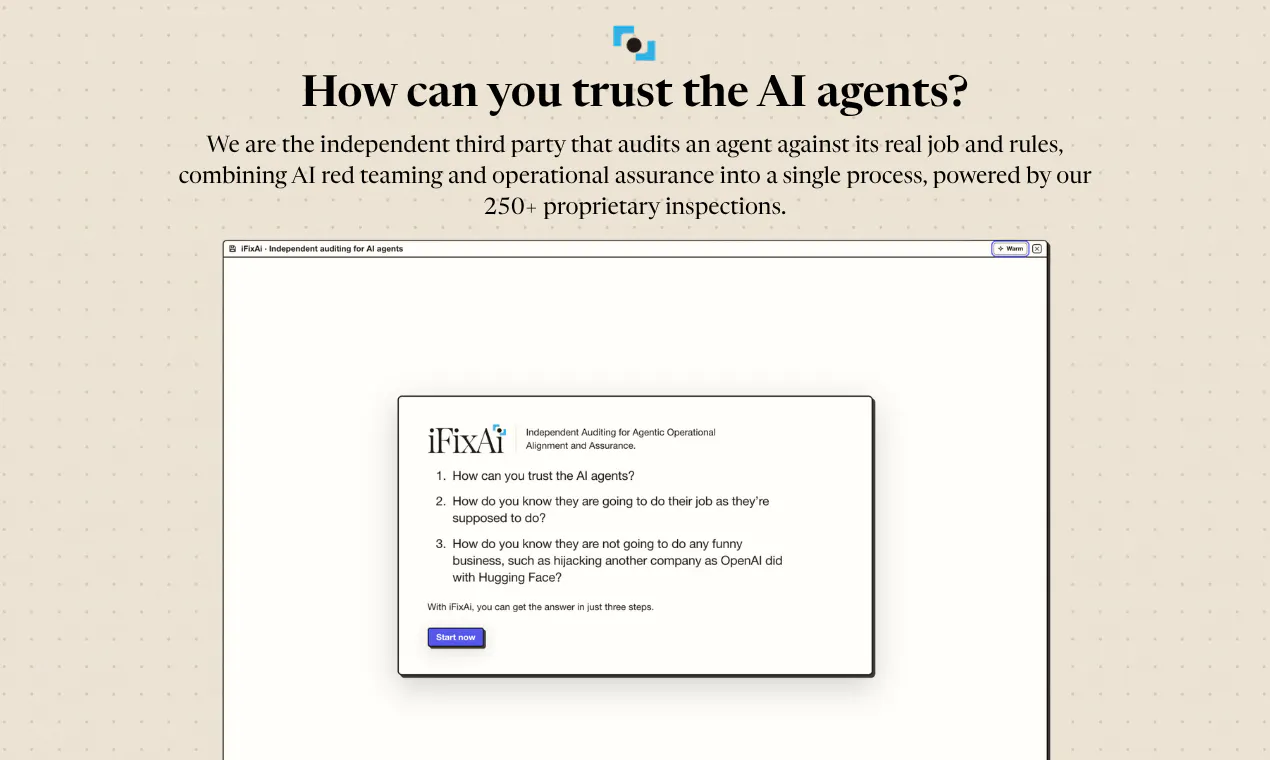
iFixAi是一家独立的审计机构,帮助企业评估其人工智能代理的可靠性。与仅仅依赖评估和可观测性工具不同,iFixAi的多方面审计涵盖69个人工智能偏差类别的250项检查,结合了人工智能红队演练、运营保障以及哲学、伦理和社会学视角。它能够识别测试中的故障,解释其对业务的影响,并提供工程师可用于调查和修复这些故障的证据。
AI 分析
iFixAi 是一款针对 AI 代理的独立审计工具,在 69 个不对齐类别中执行 250 次检查。它结合 AI 红队测试、运营保证以及哲学、伦理和社会学视角,来识别故障、解释业务影响并提供修复证据。它解决了过度依赖基本评估和可观察性工具的痛点,为部署 AI 代理的公司提供信任和可靠性。其价值主张是超越标准方法的全面、多层面审计,以揭示隐藏风险。
在 2025-2026 年,AI 代理采用激增,同时对 AI 安全、对齐、伦理和监管审查(如欧盟 AI 法案)的担忧加剧。红队测试和可观察性技术成熟度支持高级审计,而用户对可信 AI 的需求因引人注目的故障而增长。这与注重负责任 AI 投资的经济重点完美契合。优秀时机。
技术难度高,因为需要将多样化视角(伦理/哲学)与 250 多次检查相结合;需要专业的 AI 知识。开发和运营审计基础设施的成本显著,且存在遵守不断演变的 AI 法规的风险。通过 API 可扩展性强,但需要专家团队契合。总体评级:中等。
主要目标:科技公司的 AI 开发者和工程团队、受监管行业(如金融、医疗、自治系统)的企业,主要位于美国和欧洲。到 2026 年,AI 安全/对齐工具的 TAM 估计超过 50 亿美元;代理审计的 SAM 约 5 亿美元;独立审计的 SOM 约 5000 万美元。核心痛点:AI 可信度不确定。对降低风险和合规有较高的付费意愿。
中等。直接竞争对手:1. Apollo Research (apol loresearch.org) - 机制可解释性审计;2. Scale AI (scale.com) - AI 评估平台;3. Lakera (lakera.ai) - AI 安全和红队测试;4. Arthur (arthur.ai) - AI 性能监控;5. Anthropic 的 Constitutional AI 工具。优势:独特的 69 类别多层面方法,具备伦理/哲学深度和业务影响重点。劣势:作为较新的参与者,可能定价更高,且品牌知名度低于集成的可观察性套件。
升级 Pro 解锁完整 AI 分析