QAgent
QAgent
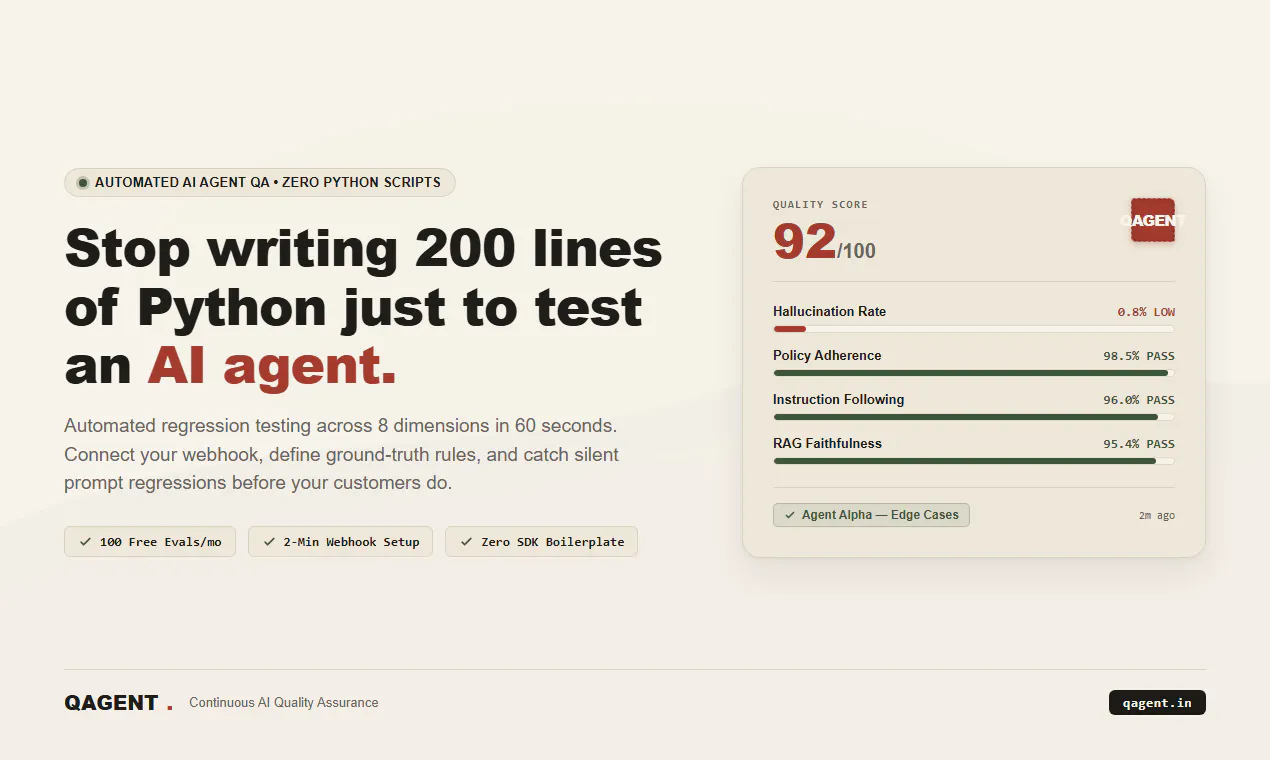
Automate AI agent quality testing. Score correctness, detect hallucinations against ground truth, verify policy adherence, and benchmark RAG before bad responses reach real customers.
AI 分析
QAgent 为 AI 代理自动化 QA,根据真实情况对正确性评分、检测幻觉、验证策略遵守并基准测试 RAG。它解决了 AI 输出不可靠、手动测试负担以及“凭感觉发布”的关键痛点,通过系统化的部署前评估实现。该产品的独特卖点是针对代理的全面自动化测试,防止不良响应到达客户。价值主张:通过数据驱动的质量保证,更快地构建和发布更可靠的 AI 代理。
在2025-2026年,AI代理在各行业的采用激增,LLM技术成熟,同时在监管对AI安全和准确性的关注下,对可信系统的需求上升。这为专业QA工具创造了强烈需求。优秀时机。
高。准确的LLM评估存在技术挑战,但可以使用当前LLM-as-judge等技术来管理。适中的开发/运营成本(测试计算),作为SaaS具有很强的可扩展性,对于软件工具供应链/合规风险低。对AI开发人员团队契合度好,可扩展潜力高。
主要细分:AI/ML工程师、AI初创公司、科技公司和构建代理/RAG的企业的开发者(主要在美国、欧洲,全球远程)。到2026年AI开发/可观察性工具的TAM约为80-100亿美元;代理QA的SAM约为8亿美元;SOM约为8000万美元。痛点:未检测到的幻觉、策略违规、可靠性差。付费意愿高(每月100-1000+美元),以避免生产失败。
中。竞争对手:1. DeepEval (confident-ai.com),2. Ragas (ragas.io),3. LangSmith (langchain.com/smith),4. Arize的Phoenix (arize.com/phoenix),5. TruLens (trulens.org)。优势:专注于代理,结合策略/幻觉/RAG测试,清晰的“停止凭感觉”定位。劣势:较新,与LangSmith相比集成/生态系统可能较少;定价未知,但必须在准确性和易用性上竞争。
升级 Pro 解锁完整 AI 分析